B.1问题空间转录组学可以测量组织切片中每个位置哪些基因在表达,但它昂贵,而且会耗尽切片。H&E 染色便宜,几乎每张临床切片都有。如果形态学包含足够的信息,一个在配对的 H&E 与空间 RNA 上训练的模型就可以为新组织估计表达图,并指出值得进一步测量的区域。预测只是关于组织的假设,而不是新的测量,所以真正的问题更具体:在模型从未见过的患者身上,空间 RNA 模式有多少能从图像中读出来?哪种训练方式最接近?数据来自三位结直肠癌患者,采用 Visium HD 测序,并在 8 µm 的 bin 尺度上分析。一个 bin 是一个网格方块,而不是一个细胞。大多数测得的计数为零,而零既可能来自采样稀疏,也可能代表真正的不表达。
B.2方法所有模型使用同一个现有病理图像编码器(HIPT)的冻结特征,以及同一个小型神经网络,只改变训练方案。MSE 用平方误差拟合对数变换后的计数;NB 用负二项似然拟合原始计数,这是过离散计数数据的标准模型;ZINB 在此基础上加入一个额外零值的概率。每种方案同时改变了训练目标和预测的读取方式,因此这是对训练方案的比较,而不是单独比较损失函数。测试以患者为单位:在两位患者上训练、在第三位上评估,轮换使每位患者都被留出一次。基因选择(约 3,000 个高变基因加一个固定的 94 个标志基因列表)、特征归一化、学习率和检查点的选择都只使用训练患者。被留出患者的 RNA 只在最终评估时使用。每种方法都有自己调优的学习率和五个全新的训练种子,没有任何方案是在另一方案的设置下被评判的。这些实验由我设计并完成,GPU 流程由我搭建,结果也由我报告;指导教授为 Tianlong Chen,导师为 Mufan Qiu 和 Ruichen Zhang,合作者为 Yi Zhang(杜克大学)。
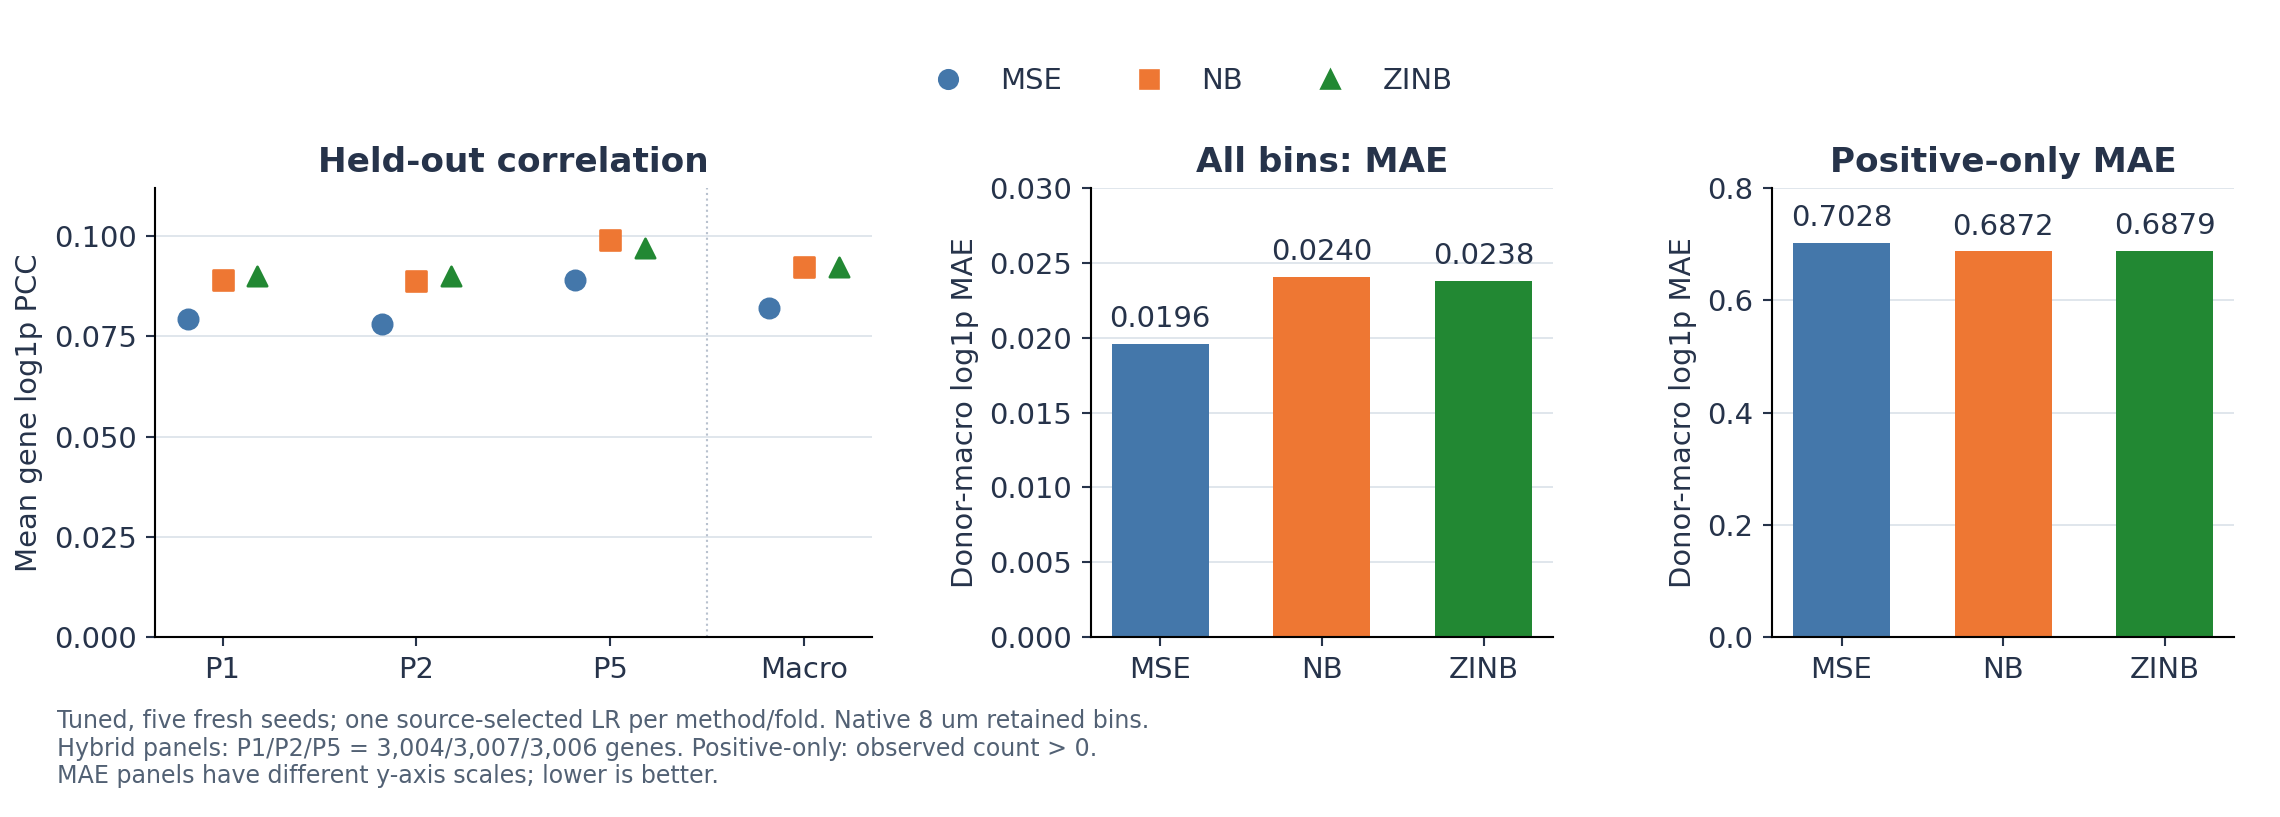
B.3我在学到什么在三位被留出的患者中,两种计数模型对基因空间高低变化的捕捉都优于 MSE,但在所有 bin 上平均的误差也更大。这并不矛盾。相关系数衡量的是预测图是否在测量图升高的地方升高;绝对误差衡量的是每个 bin 的数值偏差多少。当大多数计数为零时,处处预测接近零就可能得到很低的误差,却很少说明基因在哪里表达。计数模型把预测信号分布到更多 bin 中:相关性上升,在测得阳性的 bin 上误差下降,而在所有 bin 上的误差上升。ZINB 相比普通 NB 没有稳定的额外优势。训练方案空间相关性(PCC,越高越好)所有 bin 的误差(MAE,越低越好)测得阳性 bin 的误差(MAE)MSE0.0820.01960.703NB0.0920.02400.687ZINB0.0920.02380.688每位患者约 3,000 个基因的均值,再对三位被留出的结直肠癌患者等权平均;8 µm 尺度的对数计数;五个种子的集成。图 B1 三位结直肠癌患者的留出测试结果。左:对每位被留出的患者,基于计数的方案(NB、ZINB)对空间模式的捕捉都优于平方误差(MSE)。中:同样的方案在所有 bin 上的平均误差更大。右:在实际检测到 RNA 的位置,它们的误差略小。两个误差面板的坐标刻度不同;误差越低越好。相关系数的绝对值不高,因为基因集中有数千个基因在形态上几乎不可见。结论在于方案之间的比较,而不是数值本身。三位患者不足以证明模型在更广人群中的表现。这个项目给我最大的教训关于评估。早期的一个结果似乎显示某种训练目标有很大优势,但那些模型是在不同学习率下训练的;一旦匹配设置,差距就大幅缩小。一个更复杂的生成式方法(flow matching)在受控实验中也没有带来稳定提升。从那以后,每一次比较都先匹配设置,再解读结果。
B.4开放问题最大的缺口在生物学层面。更亮、更连续的预测图并不证明模型找到了真实的细胞。在某些区域,计数模型在测得计数很少的地方预测出大片信号,这需要独立的参照来判断。下一步是用独立标注的组织区域来评估预测,这一步尚未完成。已提出但尚未开展的后续实验将检验剩余的局限来自哪里:更新的图像编码器、简单的空间邻域信息,以及一个由预测的细胞类型组成来构建表达的模型。